2026年11月フロンティアAI三つ巴比較:Gemini 4 Neon vs GPT-6.2(Astra・Sol)vs Claude Fable 5.2
2026年11月に登場したGemini 4 Neon・GPT-6.2(Astra/Sol)・Claude Fable 5.2を徹底比較。コーディング性能、1Mコンテキスト、API料金、思考・高速モード、移行時の注意点と選び方まで解説します。
目次
- 1. 2026年11月のビッグテック3強を一望する
- 2. 自分の作業に合うモデル診断(インタラクティブ選択)
- 3. 主要スペック・API料金の徹底比較
- 4. コーディング・エージェント・推論ベンチマーク分析
- 5. 思考レベル・高速モード&API呼び出しコード
- 6. API移行時の落とし穴とシーン別マッチング
- 7. マルチモデル運用を成功させる4ステップ戦略
- 8. よくある質問(FAQ)
1. 2026年11月のビッグテック3強を一望する
2026年11月中旬、Anthropic(11月9日)、OpenAI(11月17日)、Google DeepMind(11月18日)が相次いで次世代フラッグシップを発表しました。100万(1M)トークンのコンテキスト、段階的な思考レベル調整、専用の高速推論ティアが3社共通の標準になった一方で、狙うポジションは明確に分かれています。
- Anthropic Claude Fable 5.2(
claude-fable-5-2):高難度のソフトウェア開発と長時間自律エージェントに向けた一般提供(GA)最上位モデルです。Fable 5.1比でトークン単価を20%引き下げ、生成速度を最大30%高速化。さらに最大2.5倍速のFast Modeと常時オンのAdaptive Thinkingを備えます。 - OpenAI GPT-6.2 Astra & Sol(
gpt-6.2-astra/gpt-6.2-sol):複雑な研究・セキュリティ・大規模開発向けのAstra($8/$40)と、日常コーディング・レビュー向けのSol($2/$10)を2本立てで投入しました。両モデルとも超高速ティアUltrafastに対応し、AstraはOpenAIのPreparedness Frameworkで外部公開モデル初の「AI自己改善(AI Self-Improvement)」High水準に到達しています。 - Google Gemini 4 Neon(
gemini-4-neon):軽量高速のHydrogen($1.50/$7.50)と最上位Carbon($4/$20、11月末まで$2/$10キャンペーン)の中間に位置する主力モデルです。$3/$15のミドル価格でCarbon級の推論力に迫り、256K〜1Mの長文探索や動画・音声・PDF・Office文書のネイティブ処理で圧倒的な強さを発揮します。
2. 自分の作業に合うモデル診断(インタラクティブ選択)
日々のIDE・CLI・API基盤にどのモデルを組み込むべきか、最優先のシナリオを選ぶと推奨モデルと主要スペックが表示されます。
Google Gemini 4 Neon1M長文検索・マルチモーダル・コスパ最強バランス
“Carbon級推論をミドル価格で回せる実戦型エース”
- 公開日 / ID
- 2026-11-18 / gemini-4-neon
- 標準API料金(1Mあたり)
- 入力 $3.00 ・ 出力 $15.00(キャッシュ $0.15)
- コンテキスト / 出力
- 統合1M / 同期64K(バックグラウンド最大1M)
- 主な強み
- GraphWalks 95.2%、AA Coding Agent #1、動画・音声・PDF対応
OpenAI GPT-6.2(Astra & Sol)日常のSol + 科学・セキュリティ・UltrafastのAstra
“2層構成の効率とWebSocket超高速ループを両立”
- 公開日 / ID
- 2026-11-17 / gpt-6.2-astra, gpt-6.2-sol
- 標準API料金(1Mあたり)
- Sol $2/$10 ・ Astra $8/$40(272K超で割増)
- コンテキスト / 出力
- 1.05M(最大入力922K)/ 出力128K
- 主な強み
- Agents' Last Exam 78.3%、GPQA 97%、Ultrafast対応
Anthropic Claude Fable 5.2最上位ソフトウェア開発 & 1Mフラット料金
“SWE-bench Pro 93%と2.5倍Fast Modeの決定版”
- 公開日 / ID
- 2026-11-09 / claude-fable-5-2
- 標準API料金(1Mあたり)
- 入力 $8.00 ・ 出力 $40.00(キャッシュ読取 $0.20)
- コンテキスト / 出力
- 1M(全領域フラット料金)/ 出力128K
- 主な強み
- SWE-bench Pro 93.0%、Multilingual 96.6%、2.5x Fast Mode
3. 主要スペック・API料金の徹底比較
最上位モデル(GPT-6.2 AstraとClaude Fable 5.2)はいずれも入力$8 / 出力$40で横並びとなった一方、実務で最も使われるミドル帯ではGemini 4 Neon($3/$15)、GPT-6.2 Sol($2/$10)、Claude Opus 5.5($4/$20)が激しいコスト競争を繰り広げています。
3社主要モデル スペック・料金一覧(100万トークンあたり USD)
| モデル | 公開日 | APIモデルID | コンテキスト / 最大出力 | 標準入力 / 出力 | キャッシュ読取 | 高速ティア | 備考 |
|---|---|---|---|---|---|---|---|
| Gemini 4 Neon | 2026-11-18 | gemini-4-neon | 統合1M / 64K(非同期1M) | $3.00 / $15.00 | $0.15(95%引) | Priority($5.40/$27) | 有料枠のみ・Batch 50%引 |
| Gemini 4 Carbon | 2026-11-10 (GA) | gemini-4-carbon | 1M / 64K+ | $4.00 / $20.00* | — | — | *11/30まで$2/$10導入価格 |
| Gemini 4 Hydrogen | 2026-11-12 | gemini-4-hydrogen | 1M / 64K | $1.50 / $7.50 | — | — | 無料・有料ともに利用可能 |
| GPT-6.2 Astra | 2026-11-17 | gpt-6.2-astra | 1.05M / 128K | $8.00 / $40.00 | $0.40 | Fast 2倍 / Ultrafast 3倍* | 272K超で入力2倍・出力1.5倍 |
| GPT-6.2 Sol | 2026-11-17 | gpt-6.2-sol | 1.05M / 128K | $2.00 / $10.00 | $0.10 | Fast 2倍 / Ultrafast 3倍* | Astraのちょうど1/4単価 |
| Claude Fable 5.2 | 2026-11-09 | claude-fable-5-2 | 1M / 128K | $8.00 / $40.00 | $0.20(0.025倍) | Fast 2倍($16/$80) | 1M全域で長文割増なし |
| Claude Opus 5.5 | 2026-09-22 | claude-opus-5-5 | 1M / 128K | $4.00 / $20.00 | $0.20 | 対応 | 汎用フラッグシップ推奨 |
4. コーディング・エージェント・推論ベンチマーク分析
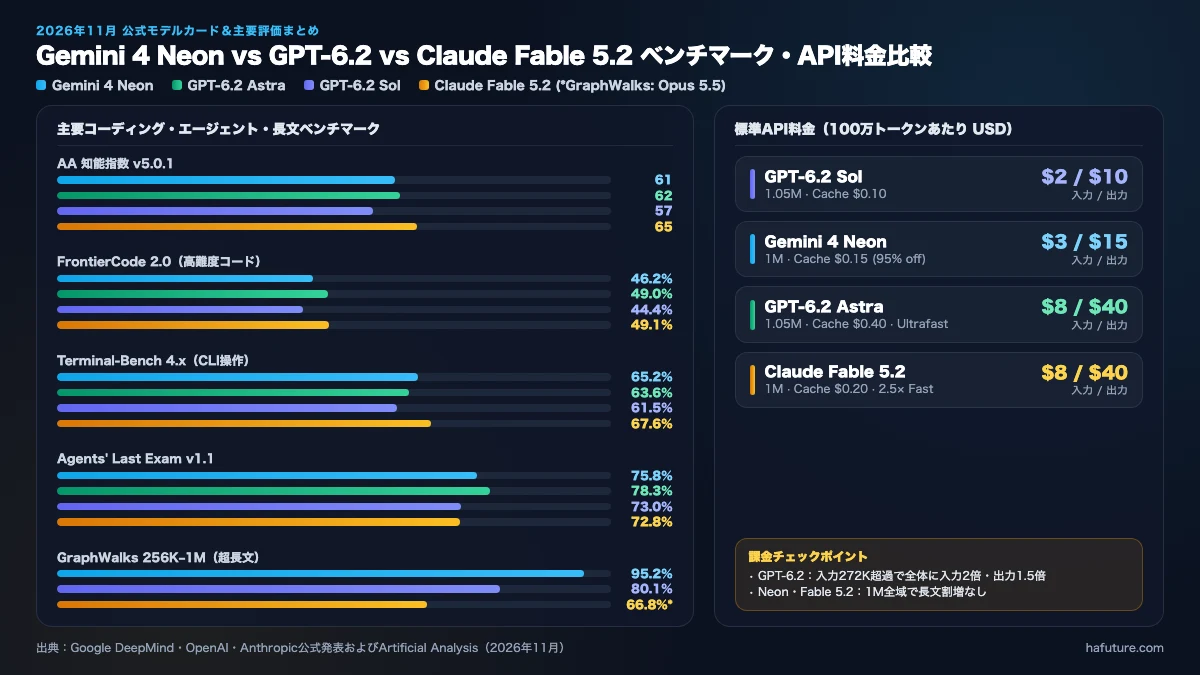
従来のSWE-bench Verifiedが飽和しつつある現在、3社の評価軸はより実践的なSWE-bench Pro、FrontierCode 2.0、Terminal-Bench 4.x、SWE-sweep、Agents' Last Examへと移行しています。
主要公開ベンチマーク比較
| 分野 | ベンチマーク | Gemini 4 Neon | GPT-6.2 Astra | GPT-6.2 Sol | Claude Fable 5.2 | 読み解きポイント |
|---|---|---|---|---|---|---|
| 総合知能 | AA Intelligence Index v5.0.1 | 61(xhigh)/ 60(high) | 62(max/xhigh) | 57(max) | 65(max) / 62(high) | Fable 5.2 maxが首位、Neonは$3/$15で60〜61到達 |
| 高難度コーディング | FrontierCode 2.0 | 46.2%(high) | 44.2% (OpenAI) / 49.0% (AA) | 43.8% (OpenAI) / 44.4% (AA) | 49.1%(xhigh) / 45.3%(high) | SolはAstraと0.5pt差を約1/5コストで達成 |
| リポジトリ修正 | SWE-bench Pro / Multilingual | — (SWE-sweep 39.0%) | — (SecureSWE 65.7%) | — (SecureSWE 55.6%) | 93.0% / 96.6% | 多言語リポジトリ修正でFable 5.2が独走 |
| ターミナル自律操作 | Terminal-Bench 4.0 / 4.1 | 65.2% (4.1) | 63.6% (Codex) | 61.5% (4.1) | 67.6% (4.0) | 実務CLIワークフローでは3社とも60%台半ば |
| 科学・研究 | Terminal-Bench-Science 0.1 | 70.5% | 77.1% | 68.0% | — | AstraはGPQA Diamond(97.0%)でもトップ級 |
| 知識エージェント | Agents' Last Exam v1.1 | 75.8% | 78.3%(xhigh) | 73.0% | 約72.8% | Astraが$2.89/タスクでFable 5.2を+5.5ptリード |
| 超長文検索 | GraphWalks(256K〜1M, BFS F1) | 95.2% | — | 80.1% | — (Opus 5.5: 66.8%) | 巨大モノレポ・長文仕様書の把握はGemini 4が圧勝 |
| 複数アプリ自動化 | AutomationBench | 56.3% | — | 41.3% | 51.4%(max) | マルチアプリ連携タスクでNeonがトップ |
数値の裏にある実務インサイト
- モデル性能を引き出すのは「ハーネス」:同じGemini 4 Neonでも、最小構成の
mini-SWEではSWE-sweep 12.8%だったのに対し、Google Antigravityのサブエージェント基盤では39.0%へ3倍以上に跳ね上がりました。モデル単体だけでなく、実行環境の選定が成果を大きく左右します。 - GPT-6.2 Solの圧倒的コスパ:FrontierCode 2.0でSol(43.8%)とAstra(44.2%)の差はわずか0.4ポイントですが、トークン単価は4分の1です。通常開発をSolに任せ、セキュリティ修正(PatchBench 79.7%)や難関設計のみAstraに上げる構成が合理的です。
- Fable 5.2の
max設定はトークン消費に注意:Claude Fable 5.2はhighからmaxに上げるとAA指数が62→65へ伸びますが、出力トークン消費は約3.2倍になります。普段はmediumまたはhighで運用し、詰まったときだけxhigh/maxを使うのが鉄則です。
5. 思考レベル・高速モード&API呼び出しコード
3社とも最新のAPIでは思考深度と高速推論ティアをリクエスト内で明示制御できます。すぐ試せる公式形式のサンプルです。
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
-H "x-goog-api-key: $GEMINI_API_KEY" \
-H "Content-Type: application/json" \
-d '{
  "model": "gemini-4-neon",
  "input": "このNext.jsルートハンドラのメモリリーク原因を特定し、最小修正パッチを提示してください。",
  "generation_config": {
    "thinking_level": "high"
  }
}'6. API移行時の落とし穴とシーン別マッチング
モデルIDだけを書き換えると、非推奨パラメータの厳格化により400エラーが出やすくなっています。状況別に最適解を検索できます。
- 毎日大量のPRレビュー・単体テスト・UI実装を回したい日常主力· コーディング・エージェント
日常業務に$8/$40枠を使うと月額が跳ね上がります。Codex v0.171標準のSolか、長文に強いNeonをベースにするのが最適です。
推奨アプローチ:GPT-6.2 Sol($2/$10)または Gemini 4 Neon($3/$15)代替案:Claude Opus 5.5($4/$20) - 数十ファイルにまたがる設計変更や難関バグを一発で解決したい最高精度· コーディング・エージェント
SWE-bench Pro 93.0%・Multilingual 96.6%のFable 5.2が最有力。トークン急増を避けるためmaxではなくhigh/xhighから試しましょう。
推奨アプローチ:Claude Fable 5.2(effort: xhigh)代替案:GPT-6.2 Astra - 300K〜800Kトークンの巨大リポジトリや長いデモ動画・PDF仕様書を読み込みたい超長文・動画· コーディング・エージェント
NeonはGraphWalks 95.2%・LVBench 89.0%と長文・動画に強く、1M全域で長文割増が発生しません。
推奨アプローチ:Gemini 4 Neon(thinking_level: high)代替案:Claude Fable 5.2(テキスト・画像/PDF) - GPT-6.2のAPI請求額が長いセッションで急に2倍になった料金注意· コスト・速度最適化
GPT-6.2は入力が272Kを1トークンでも超えるとリクエスト全体に入力2倍・出力1.5倍が適用されます。
推奨アプローチ:入力トークンが272Kを超える前に会話を要約・圧縮する代替案:272K超の案件はGemini 4 NeonまたはFable 5.2へ逃がす - 対話型エージェントやライブコーディングで応答速度を最優先したい低遅延· コスト・速度最適化
Sol Ultrafastは2027年2月末まで$6/$30(Pro $200にも同梱)。Fable 5.2 Fastは出力生成を最大2.5倍高速化します。
推奨アプローチ:GPT-6.2 Sol Ultrafast または Claude Fable 5.2 Fast代替案:Gemini 4 Hydrogen($1.50/$7.50) - claude-fable-5-2へ切り替えたら400 Bad Requestが多発する破壊的変更· API移行エラー対策
Fable 5.2はAdaptive Thinking無効化や旧budget_tokens、サンプリング指定、assistant prefillを400で拒否します。thinkingブロック再送前の履歴改変もStrict Prefix Checkでエラーになります。
推奨アプローチ:temperature・top_p・thinking.disabled・強制tool_choiceを削除代替案:output_config.effortとtool_choice: autoへ統一 - Gemini 4 Neonで既存の思考設定を送ると400エラーが返る破壊的変更· API移行エラー対策
Neonは旧minimal指定に非対応で、thinkingBudgetとthinkingLevelの併用も400エラーになります。
推奨アプローチ:thinking_levelをlow/medium/high/xhighのいずれかに変更代替案:非推奨のthinkingBudgetフィールドを完全削除
7. マルチモデル運用を成功させる4ステップ戦略
1つのベンダーに固定するより、役割ごとに2〜3モデルを組み合わせる構成がコストと品質の最適解です。
- 1日常業務の70〜80%をミドル価格帯に固定
gpt-6.2-sol / gemini-4-neon通常の機能実装・レビュー・テスト作成はGPT-6.2 Sol($2/$10)やGemini 4 Neon($3/$15)に割り当て、固定費を抑えます。
- 2上位15〜20%の難題のみフラッグシップへ昇格
claude-fable-5-2 / gpt-6.2-astra複雑なマルチファイル改修はClaude Fable 5.2(high/xhigh)、セキュリティパッチや科学・法務推論はGPT-6.2 Astraへルーティングします。
- 3プロンプトキャッシュとBatch APIで50〜95%削減
Batch (0.5x) + Prompt Cache3社すべてBatch API 50%割引を提供。Gemini 4 Neonの95%キャッシュ割引($0.15)やFable 5.2の$0.20キャッシュ読取を活用して反復コンテキスト費用を圧縮します。
- 4マルチエージェント作業場でCLIとAPIを統合
Paseo / OpenCode / Claude Code / Codex複数のコーディングCLIを並列管理できるワークスペースを使えば、既存サブスクリプションを活かしつつ最新モデルの強みを即座に切り替えられます。
8. よくある質問(FAQ)
Q1. 11月末までGemini 4 Carbonが$2/$10なのにNeon($3/$15)を使う意味はありますか?
Q2. Claude Fable 5.2とClaude Mythos 5.2の違いは何ですか?
Q3. GPT-6.2 AstraとSolは通常のChatGPTプランでも使えますか?
Q4. Claude Fable 5.2でセーフガードによりブロックされた場合の挙動は?
Q5. 主要なAIコーディングCLIにはすでに対応していますか?
Hafuture リアルタイム為替計算機でAI API月額を日本円換算
Gemini 4 Neon・GPT-6.2・Claude Fable 5.2のドル建てAPI見積もりを、ブラウザ内で100%ローカル&リアルタイム為替レートで即座に円換算できます。