Gemini 4 Neon vs GPT-6.2 (Astra y Sol) vs Claude Fable 5.2: Guía IA Nov 2026
Compara Gemini 4 Neon, GPT-6.2 (Astra y Sol) y Claude Fable 5.2: benchmarks de código, contexto de 1M, precios API, modos rápidos y guía de elección.
Índice
- 1. Panorama del duelo IA de noviembre de 2026
- 2. Selector interactivo de modelo para tu flujo
- 3. Comparativa de especificaciones y precios API
- 4. Benchmarks de código, agentes y razonamiento
- 5. Niveles de razonamiento, modos rápidos y llamadas API
- 6. Errores de migración y buscador por escenario
- 7. Estrategia práctica de enrutamiento multimodelo en 4 pasos
- 8. Preguntas frecuentes (FAQ)
1. Panorama del duelo IA de noviembre de 2026
Noviembre de 2026 fijó un nuevo estándar base para equipos de ingeniería: ventanas de contexto de 1M de tokens, profundidad de razonamiento configurable, modos de inferencia acelerada y optimización para agentes de código. Aun así, cada laboratorio ocupa una posición muy clara:
- Anthropic Claude Fable 5.2 (
claude-fable-5-2): El modelo de disponibilidad general más potente de Anthropic para ingeniería de software compleja y agentes de larga duración. Frente a Fable 5.1 baja el precio un 20% ($8/$40), acelera la salida hasta un 30%, estrena Fast Mode (2.5x) y activa Adaptive Thinking de forma permanente. - OpenAI GPT-6.2 Astra y Sol (
gpt-6.2-astra,gpt-6.2-sol): Una pareja complementaria: Astra ($8/$40) para proyectos complejos, ciberseguridad, ciencia y uso de ordenador, junto a Sol ($2/$10) para programación diaria y revisión de PRs a una cuarta parte del coste. Ambos incluyen el nuevo nivel Ultrafast, y Astra es el primer modelo externo de OpenAI en alcanzar el nivel "High" de Automejora de IA en su Preparedness Framework. - Google Gemini 4 Neon (
gemini-4-neon): Situado entre Gemini 4 Hydrogen ($1.50/$7.50) y Gemini 4 Carbon ($4/$20estándar;$2/$10promocional hasta el 30 de noviembre). Por$3/$15, Neon ofrece razonamiento cercano a Carbon con menor coste por tarea, contexto unificado de 1M (con decodificación larga en segundo plano de hasta 1M) y multimodalidad nativa en texto, imagen, audio, vídeo, PDF y documentos Office.
2. Selector interactivo de modelo para tu flujo
Selecciona el objetivo principal de tu proyecto para ver el modelo recomendado y sus especificaciones clave.
Google Gemini 4 NeonRazonamiento frontera, 1M real y multimodalidad nativa
“Calidad cercana a Carbon con agilidad y precio intermedio”
- Lanzamiento / ID
- 18 nov 2026 / gemini-4-neon
- Tarifa estándar (1M)
- $3.00 entrada / $15.00 salida ($0.15 caché)
- Contexto / Salida
- 1M unificado / 64K síncrono (1M en segundo plano)
- Puntos fuertes
- GraphWalks 95.2%, AA Coding Agent #1, vídeo/audio/PDF
OpenAI GPT-6.2 (Astra y Sol)Sol para el día a día + Astra para ciencia, seguridad y Ultrafast
“Eficiencia en dos niveles con bucles de agente ultrarrápidos”
- Lanzamiento / IDs
- 17 nov 2026 / gpt-6.2-astra, gpt-6.2-sol
- Tarifa estándar (1M)
- Sol $2/$10 · Astra $8/$40 (recargo >272K)
- Contexto / Salida
- 1.05M (922K entrada máx.) / 128K salida
- Puntos fuertes
- Agents' Last Exam 78.3%, GPQA 97%, modo Ultrafast
Anthropic Claude Fable 5.2Ingeniería de software líder y tarifa plana hasta 1M
“93% en SWE-bench Pro con Fast Mode 2.5x”
- Lanzamiento / ID
- 9 nov 2026 / claude-fable-5-2
- Tarifa estándar (1M)
- $8.00 entrada / $40.00 salida ($0.20 lectura caché)
- Contexto / Salida
- 1M (sin recargo por contexto largo) / 128K salida
- Puntos fuertes
- SWE-bench Pro 93.0%, Multilingual 96.6%, Fast Mode 2.5x
3. Comparativa de especificaciones y precios API
En la gama más alta los precios se alinearon exactamente en $8.00 de entrada / $40.00 de salida por millón de tokens (GPT-6.2 Astra y Claude Fable 5.2), mientras que la gran batalla por el presupuesto diario se libra en el rango de $2 a $4 de entrada.
Tabla de gama alta e intermedia (USD por 1M de tokens)
| Modelo | Fecha | ID de API | Contexto / Salida máx. | Estándar In / Out | Lectura caché | Modo rápido | Notas |
|---|---|---|---|---|---|---|---|
| Gemini 4 Neon | 18 nov 2026 | gemini-4-neon | 1M unificado / 64K (1M async) | $3.00 / $15.00 | $0.15 (95% dto.) | Priority ($5.40/$27) | Solo pago; Batch 50% dto. |
| Gemini 4 Carbon | 10 nov 2026 (GA) | gemini-4-carbon | 1M / 64K+ | $4.00 / $20.00* | — | — | *Promo $2/$10 hasta 30 nov |
| Gemini 4 Hydrogen | 12 nov 2026 | gemini-4-hydrogen | 1M / 64K | $1.50 / $7.50 | — | — | Disponible en capa gratis y pago |
| GPT-6.2 Astra | 17 nov 2026 | gpt-6.2-astra | 1.05M / 128K | $8.00 / $40.00 | $0.40 | Fast 2x / Ultrafast 3x* | >272K entrada: 2x in, 1.5x out |
| GPT-6.2 Sol | 17 nov 2026 | gpt-6.2-sol | 1.05M / 128K | $2.00 / $10.00 | $0.10 | Fast 2x / Ultrafast 3x* | Exactamente 1/4 del precio de Astra |
| Claude Fable 5.2 | 9 nov 2026 | claude-fable-5-2 | 1M / 128K | $8.00 / $40.00 | $0.20 (0.025x) | Fast 2x ($16/$80) | Sin recargo en todo 1M |
| Claude Opus 5.5 | 22 sep 2026 | claude-opus-5-5 | 1M / 128K | $4.00 / $20.00 | $0.20 | Disponible | Modelo general recomendado |
4. Benchmarks de código, agentes y razonamiento
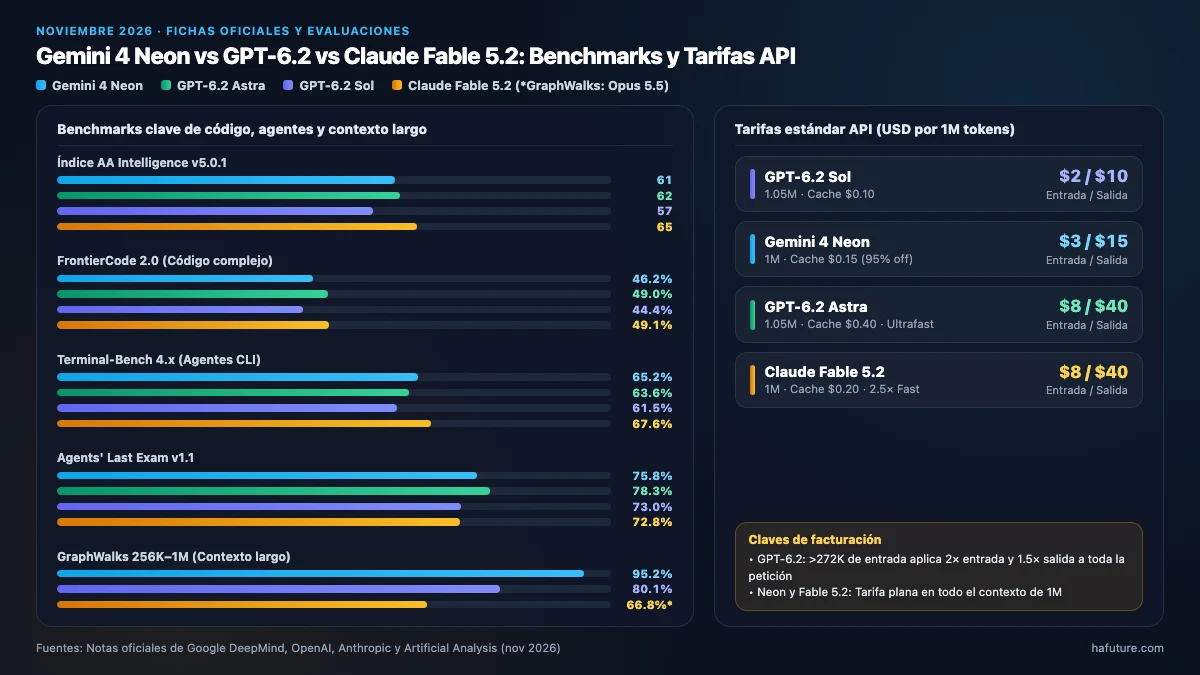
Con el antiguo SWE-bench Verified cerca del techo, las pruebas de noviembre de 2026 se enfocan en evaluaciones mucho más exigentes: SWE-bench Pro, FrontierCode 2.0, Terminal-Bench 4.x, SWE-sweep y Agents' Last Exam.
Resumen de resultados publicados
| Área | Benchmark | Gemini 4 Neon | GPT-6.2 Astra | GPT-6.2 Sol | Claude Fable 5.2 | Lectura práctica |
|---|---|---|---|---|---|---|
| Inteligencia global | AA Intelligence Index v5.0.1 | 61 (xhigh) / 60 (high) | 62 (max/xhigh) | 57 (max) | 65 (max) / 62 (high) | Fable 5.2 max lidera; Neon logra 60–61 por $3/$15 |
| Código avanzado | FrontierCode 2.0 | 46.2% (high) | 44.2% (OpenAI) / 49.0% (AA) | 43.8% (OpenAI) / 44.4% (AA) | 49.1% (xhigh) / 45.3% (high) | Sol queda a 0.5 pts de Astra con ~1/5 del coste por tarea |
| Parches en repos | SWE-bench Pro / Multilingual | — (SWE-sweep 39.0%) | — (SecureSWE 65.7%) | — (SecureSWE 55.6%) | 93.0% / 96.6% | Fable 5.2 domina la resolución multilenguaje |
| Agentes en terminal | Terminal-Bench 4.0 / 4.1 | 65.2% (4.1) | 63.6% (Codex) | 61.5% (4.1) | 67.6% (4.0) | Los tres rondan el 62–68% en flujos CLI reales |
| Ciencia e investigación | Terminal-Bench-Science 0.1 | 70.5% | 77.1% | 68.0% | — | Astra también alcanza 97.0% en GPQA Diamond |
| Trabajo de conocimiento | Agents' Last Exam v1.1 | 75.8% | 78.3% (xhigh) | 73.0% | ~72.8% | Astra lidera a $2.89/tarea (+5.5 pts sobre Fable 5.2) |
| Contexto ultralargo | GraphWalks (256K–1M, BFS F1) | 95.2% | — | 80.1% | — (Opus 5.5: 66.8%) | Clara superioridad de Gemini 4 en memoria larga |
| Automatización multiapp | AutomationBench | 56.3% | — | 41.3% | 51.4% (max) | Neon destaca en flujos empresariales con varias apps |
Tres conclusiones clave más allá de la tabla
- El arnés (harness) multiplica al modelo: En SWE-sweep, Gemini 4 Neon pasó del 12.8% con el arnés mínimo
mini-SWEal 39.0% dentro de Google Antigravity con orquestación de subagentes. El entorno de ejecución importa tanto como el modelo base. - GPT-6.2 Sol es la gran ganga silenciosa: Quedarse a 0.4–0.5 puntos de Astra en FrontierCode 2.0 pagando una cuarta parte lo convierte en el valor por defecto ideal para Codex CLI y revisiones automáticas de PR, dejando Astra para parches críticos (PatchBench 79.7%) e investigación.
- Cuidado con el salto de coste en
maxde Fable 5.2: Pasar dehighamaxeleva la puntuación en Artificial Analysis (62 → 65), pero multiplica por ~3.2x los tokens de salida. Manténmediumohighen el día a día y reservaxhigh/maxpara incidencias realmente complejas.
5. Niveles de razonamiento, modos rápidos y llamadas API
Las tres API permiten ajustar explícitamente la profundidad del razonamiento y la velocidad de inferencia. Aquí tienes plantillas listas para copiar y probar:
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
-H "x-goog-api-key: $GEMINI_API_KEY" \
-H "Content-Type: application/json" \
-d '{
  "model": "gemini-4-neon",
  "input": "Diagnostica la fuga de memoria en este handler de Next.js y genera un parche mínimo.",
  "generation_config": {
    "thinking_level": "high"
  }
}'6. Errores de migración y buscador por escenario
Cambiar solo el nombre del modelo suele disparar errores 400 en esta generación debido a la retirada de parámetros antiguos de pensamiento y muestreo. Filtra tu caso abajo:
- Ejecutar decenas de revisiones de PR, pruebas unitarias y tareas diariasUso diario· Código y agentes
Evita pagar $8/$40 en turnos rutinarios. Sol es el modelo por defecto en Codex v0.171 y Neon brilla cuando el contexto multiarchivo crece.
Acción recomendada:GPT-6.2 Sol ($2/$10) o Gemini 4 Neon ($3/$15)Alternativa:Claude Opus 5.5 ($4/$20) - Refactorizaciones profundas en decenas de archivos o bugs críticos de producciónMáxima precisión· Código y agentes
Con 93.0% en SWE-bench Pro y 96.6% en SWE-bench Multilingual, Fable 5.2 ofrece la mayor consistencia. Empieza en high o xhigh antes de usar max.
Acción recomendada:Claude Fable 5.2 (effort: xhigh)Alternativa:GPT-6.2 Astra - Analizar monorrepos de 300K–800K tokens, grabaciones largas o PDFs densosContexto largo· Código y agentes
Neon alcanza 95.2% en GraphWalks (256K–1M) y 89.0% en vídeo largo (LVBench), sin recargo adicional hasta el millón de tokens.
Acción recomendada:Gemini 4 Neon (thinking_level: high)Alternativa:Claude Fable 5.2 (texto/imagen/PDF) - Mi factura de GPT-6.2 se duplicó en sesiones largas de agentesAlerta de coste· Coste y latencia
Superar los 272K tokens de entrada en GPT-6.2 Astra o Sol aplica 2x en entrada/caché y 1.5x en salida a toda la solicitud.
Acción recomendada:Compacta la sesión antes de alcanzar 272K tokens de entradaAlternativa:Enruta sesiones >272K a Gemini 4 Neon o Fable 5.2 - Flujos interactivos donde la velocidad de respuesta define la experienciaBaja latencia· Coste y latencia
Sol Ultrafast cuesta $6/$30 hasta feb 2027 (y viene incluido en ChatGPT Pro $200). Fable 5.2 Fast acelera la salida hasta 2.5x en todo el contexto de 1M.
Acción recomendada:GPT-6.2 Sol Ultrafast o Claude Fable 5.2 FastAlternativa:Gemini 4 Hydrogen ($1.50/$7.50) - Al pasar a claude-fable-5-2 aparecen errores 400 Bad RequestCambio crítico· Cambios incompatibles API
Fable 5.2 exige Adaptive Thinking activo y Strict Prefix Checks: alterar el prompt del sistema o mensajes previos antes de reenviar un bloque thinking devuelve 400.
Acción recomendada:Elimina temperature, top_p, thinking.disabled y tool_choice forzadoAlternativa:Usa output_config.effort y tool_choice: auto - Gemini 4 Neon rechaza mi configuración previa de pensamiento con HTTP 400Cambio crítico· Cambios incompatibles API
Neon no admite el valor minimal y devuelve error si envías thinkingBudget junto con thinkingLevel.
Acción recomendada:Configura thinking_level en low, medium, high o xhighAlternativa:Elimina el campo obsoleto thinkingBudget
7. Estrategia práctica de enrutamiento multimodelo en 4 pasos
En lugar de depender de un único proveedor, los equipos más eficientes combinan dos o tres modelos según la dificultad de la tarea:
- 1Asigna el 70–80% del tráfico diario a un modelo intermedio
gpt-6.2-sol / gemini-4-neonEnruta implementación cotidiana, pruebas y revisiones de PR a GPT-6.2 Sol ($2/$10) o Gemini 4 Neon ($3/$15) para mantener el gasto bajo control.
- 2Escala solo el 15–20% más difícil a la gama alta
claude-fable-5-2 / gpt-6.2-astraUsa Claude Fable 5.2 (high/xhigh) en refactorizaciones profundas y reserva GPT-6.2 Astra para parches de seguridad, ciencia y razonamiento estricto.
- 3Combina caché de prompts y Batch API (50–95% de ahorro)
Batch (0.5x) + Prompt CacheLos tres ofrecen 50% en Batch API. Aprovecha el 95% de descuento en caché de Neon ($0.15) y la lectura caché de $0.20 (0.025x) en Fable 5.2.
- 4Integra tus CLI y APIs en un workspace multiagente
Paseo / OpenCode / Claude Code / CodexTrabaja con un orquestador o CLI agnóstico para alternar entre Claude Code, Codex y Antigravity sin rehacer tu configuración.
8. Preguntas frecuentes (FAQ)
Q1. ¿Por qué usar Gemini 4 Neon ($3/$15) si Carbon está en promo a $2/$10?
Q2. ¿En qué se diferencian Claude Fable 5.2 y Claude Mythos 5.2?
Q3. ¿Dónde están disponibles GPT-6.2 Astra y Sol?
Q4. ¿Cómo gestiona Claude Fable 5.2 los rechazos por salvaguardas?
Q5. ¿Ya funcionan en los CLI de programación más populares?
Calcula tu presupuesto mensual de API IA con el Conversor de Divisas de Hafuture
Convierte en tiempo real los precios en USD de Gemini 4 Neon, GPT-6.2 y Claude Fable 5.2 a tu moneda local directamente en tu navegador.