2026년 11월 프런티어 AI 3파전: Gemini 4 Neon vs GPT-6.2(Astra·Sol) vs Claude Fable 5.2 완벽 비교
2026년 11월 열흘 사이 출시된 Gemini 4 Neon, GPT-6.2(Astra·Sol), Claude Fable 5.2의 코딩 벤치마크, 1M 컨텍스트, API 가격, 추론·고속 모드와 실무 선택 기준을 비교했습니다.
목차
- 1. 2026년 11월 빅테크 3파전 한눈에 보기
- 2. 내 작업에 맞는 모델 찾기 (인터랙티브 선택기)
- 3. 핵심 스펙 및 API 가격 완벽 비교
- 4. 코딩·에이전트·추론 벤치마크 분석
- 5. 추론 레벨·고속 모드 & API 호출 코드
- 6. 마이그레이션 주의사항과 실전 상황별 매칭
- 7. 멀티 모델 라우팅 실전 4단계 전략
- 8. 자주 묻는 질문 (FAQ)
1. 2026년 11월 빅테크 3파전 한눈에 보기
2026년 11월은 AI 개발 생태계에서 가장 숨 가쁜 열흘이었습니다. Anthropic(11월 9일), OpenAI(11월 17일), Google DeepMind(11월 18일)가 차례로 차세대 주력 모델을 공개하면서, 100만(1M) 토큰 컨텍스트와 에이전트 코딩이 사실상 기본 스펙이 되었습니다.
세 진영의 포지셔닝은 과거보다 훨씬 선명하게 갈렸습니다.
- Anthropic Claude Fable 5.2 (
claude-fable-5-2): 가장 복잡한 소프트웨어 엔지니어링과 장기 자율 에이전트에 특화된 최상위 모델입니다. 이전 세대(Fable 5.1)보다 토큰 가격을 20% 낮추고 생성 속도를 최대 30% 끌어올렸으며, 2.5배 빠른 Fast Mode와 상시 작동하는 Adaptive Thinking을 전면에 내세웠습니다. - OpenAI GPT-6.2 Astra & Sol (
gpt-6.2-astra,gpt-6.2-sol): 최상위 추론·보안·리서치용 Astra($8/$40)와 일상 코딩·코드 리뷰·고빈도 에이전트용 Sol($2/$10)을 한 쌍으로 투입했습니다. 특히 Astra는 OpenAI의 Preparedness Framework에서 외부 공개 모델 최초로 'AI 자기 개선(AI Self-Improvement)' High 등급에 도달했고, 두 모델 모두 초고속 Ultrafast 티어를 지원합니다. - Google Gemini 4 Neon (
gemini-4-neon): 초경량 Hydrogen($1.50/$7.50)과 최고 사양 Carbon($4/$20, 11월 말까지 프로모션 $2/$10) 사이에 자리 잡은 '스위트 스팟' 모델입니다. $3/$15의 중간 가격대로 Carbon급 추론력에 근접하면서, 256K~1M 초장문 탐색과 멀티모달(오디오·비디오·PDF·오피스 문서)에서 독보적인 강점을 보입니다.
2. 내 작업에 맞는 모델 찾기 (인터랙티브 선택기)
"그래서 당장 내 프로젝트와 코딩 CLI에는 어떤 모델을 걸어야 할까?" 아래에서 가장 가까운 상황을 선택하면 추천 모델과 핵심 스펙을 바로 확인할 수 있습니다.
Google Gemini 4 Neon1M 장문·멀티모달·가성비 프런티어 밸런스
“Carbon급 추론에 Flash급 민첩함을 더한 실전형 주력기”
- 출시일 / ID
- 2026-11-18 / gemini-4-neon
- 표준 가격 (1M당)
- 입력 $3.00 · 출력 $15.00 (캐시 $0.15)
- 컨텍스트 / 출력
- 통합 1M / 동기 64K (백그라운드 최대 1M)
- 핵심 강점
- GraphWalks 95.2%, AA Coding Agent #1, 영상·오디오·PDF 네이티브
OpenAI GPT-6.2 (Astra & Sol)일상용 Sol + 최상위 과학·보안·Ultrafast Astra
“가성비와 최고점, 초저지연 Ultrafast를 한 API에서 조합”
- 출시일 / ID
- 2026-11-17 / gpt-6.2-astra, gpt-6.2-sol
- 표준 가격 (1M당)
- Sol $2/$10 · Astra $8/$40 (272K 초과 시 할증)
- 컨텍스트 / 출력
- 1.05M (입력 최대 922K) / 출력 128K
- 핵심 강점
- Agents' Last Exam 78.3%, GPQA 97%, Ultrafast(WebSocket)
Anthropic Claude Fable 5.2최상위 소프트웨어 엔지니어링 & 장기 에이전트
“SWE-bench Pro 93%와 1M 단일 요금제의 코딩 종결자”
- 출시일 / ID
- 2026-11-09 / claude-fable-5-2
- 표준 가격 (1M당)
- 입력 $8.00 · 출력 $40.00 (캐시 읽기 $0.20)
- 컨텍스트 / 출력
- 1M (전 구간 단일 요금) / 출력 128K
- 핵심 강점
- SWE-bench Pro 93.0%, Multilingual 96.6%, 2.5x Fast Mode
3. 핵심 스펙 및 API 가격 완벽 비교
이번 11월 출시에서 가장 눈에 띄는 변화는 가격 계층의 재편입니다. 최상위 티어(GPT-6.2 Astra, Claude Fable 5.2)가 나란히 입력 $8 / 출력 $40으로 정렬된 반면, 미들 티어에서는 Gemini 4 Neon($3/$15)과 GPT-6.2 Sol($2/$10), Claude Opus 5.5($4/$20)가 치열하게 맞붙고 있습니다.
3사 주요 라인업 스펙·요금 비교 (100만 토큰당 USD)
| 모델 | 출시일 | API 모델 ID | 컨텍스트 / 최대 출력 | 표준 입력 / 출력 | 캐시 읽기 | 고속 모드 | 비고 |
|---|---|---|---|---|---|---|---|
| Gemini 4 Neon | 2026-11-18 | gemini-4-neon | 통합 1M / 64K (장기 1M) | $3.00 / $15.00 | $0.15 (95% 할인) | Priority ($5.40/$27) | 무료 티어 없음, Batch 50% 할인 |
| Gemini 4 Carbon | 2026-11-10 (GA) | gemini-4-carbon | 1M / 64K+ | $4.00 / $20.00* | — | — | *11월 30일까지 $2/$10 프로모션 |
| Gemini 4 Hydrogen | 2026-11-12 | gemini-4-hydrogen | 1M / 64K | $1.50 / $7.50 | — | — | 무료·유료 모두 제공 |
| GPT-6.2 Astra | 2026-11-17 | gpt-6.2-astra | 1.05M / 128K | $8.00 / $40.00 | $0.40 | Fast 2배 / Ultrafast 3배* | 272K 초과 시 입력 2배·출력 1.5배 |
| GPT-6.2 Sol | 2026-11-17 | gpt-6.2-sol | 1.05M / 128K | $2.00 / $10.00 | $0.10 | Fast 2배 / Ultrafast 3배* | Astra 대비 정확히 1/4 단가 |
| Claude Fable 5.2 | 2026-11-09 | claude-fable-5-2 | 1M / 128K | $8.00 / $40.00 | $0.20 (0.025배) | Fast 2배 ($16/$80) | 1M 전 구간 장문 할증 없음 |
| Claude Opus 5.5 | 2026-09-22 | claude-opus-5-5 | 1M / 128K | $4.00 / $20.00 | $0.20 | 지원 | 일상 플래그십 기본 권장 모델 |
4. 코딩·에이전트·추론 벤치마크 분석
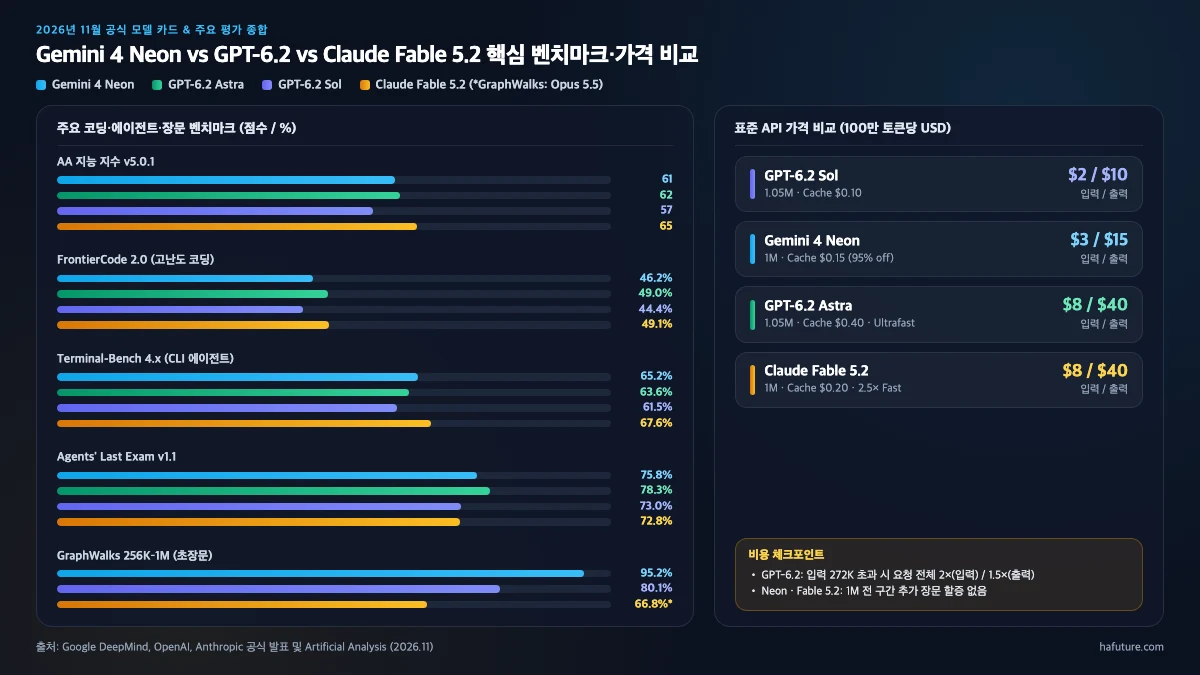
2026년 하반기부터는 기존 SWE-bench Verified가 포화 상태에 가까워지면서, 3사 모두 더 까다로운 실전형 에이전트 지표(SWE-bench Pro, FrontierCode 2.0, Terminal-Bench 4.x, SWE-sweep, Agents' Last Exam)를 중심으로 경쟁하고 있습니다.
주요 공개 벤치마크 비교표
| 벤치마크 영역 | 지표 | Gemini 4 Neon | GPT-6.2 Astra | GPT-6.2 Sol | Claude Fable 5.2 | 해석 포인트 |
|---|---|---|---|---|---|---|
| 종합 지능 | AA Intelligence Index v5.0.1 | 61 (xhigh) / 60 (high) | 62 (max/xhigh) | 57 (max) | 65 (max) / 62 (high) | Fable 5.2 max가 최고점, Neon은 $3/$15로 60~61 달성 |
| 고난도 코딩 | FrontierCode 2.0 | 46.2% (high) | 44.2% (OpenAI) / 49.0% (AA) | 43.8% (OpenAI) / 44.4% (AA) | 49.1% (xhigh) / 45.3% (high) | Sol은 Astra와 0.5%p 차이를 1/5 작업 비용으로 기록 |
| SWE 저장소 수리 | SWE-bench Pro / Multilingual | — (SWE-sweep 39.0%) | — (SecureSWE 65.7%) | — (SecureSWE 55.6%) | 93.0% / 96.6% | Fable 5.2의 코드 수정·다언어 저장소 완성도 압도적 |
| 터미널 에이전트 | Terminal-Bench 4.0 / 4.1 | 65.2% (4.1) | 63.6% (Codex) | 61.5% (4.1) | 67.6% (4.0) | 실전 CLI 디버깅·배포 시나리오에서 3사 모두 60%대 중반 |
| 과학·연구 | Terminal-Bench-Science 0.1 | 70.5% | 77.1% | 68.0% | — | 과학·수치 분석 및 GPQA Diamond(97.0%)에서 Astra 선두 |
| 에이전트 지식 업무 | Agents' Last Exam v1.1 | 75.8% | 78.3% (xhigh) | 73.0% | 72.8% 수준 | Astra가 $2.89/작업으로 Fable 5.2 대비 +5.5%p 우위 |
| 초장문 탐색 | GraphWalks (256K~1M, BFS F1) | 95.2% | — | 80.1% | — (Opus 5.5: 66.8%) | 대규모 모노레포·긴 문서 맥락 유지에서 Gemini 4 압승 |
| 멀티앱 자동화 | AutomationBench | 56.3% | — | 41.3% | 51.4% (max) | 여러 앱을 오가는 실무 자동화에서 Neon 강세 |
벤치마크 숫자 너머로 읽어야 할 핵심 인사이트
- 하네스(Harness)가 모델만큼 중요해진 시대: Gemini 4 Neon은 동일한 가중치인데도 최소 하네스(
mini-SWE)에서는 SWE-sweep 12.8%, 구글 Antigravity 멀티 에이전트 하네스에서는 39.0%로 3배 넘게 뛰었습니다. 어떤 모델을 고르느냐만큼 어떤 코딩 에이전트·오케스트레이션 도구 위에서 돌리느냐가 결과를 가릅니다. - GPT-6.2 Sol의 미친 가성비: FrontierCode 2.0에서 GPT-6.2 Sol(43.8%)은 형님 모델 Astra(44.2%)와 불과 0.4%p 차이인데 토큰 단가는 정확히 4분의 1입니다. 일상적인 PR 리뷰·기능 구현은 Sol을 기본으로 두고, 보안 패치(PatchBench 79.7%)나 고난도 아키텍처만 Astra로 올리는 전략이 합리적입니다.
- Fable 5.2의
max노력(effort) 함정: Claude Fable 5.2는max설정 시 AA 지수 65점으로 최강이지만,high대비 출력 토큰을 약 3.2배 더 소비합니다. 평소에는 API 기본값인high나 Claude Code 기본값인medium으로 두고, 진짜 막히는 버그에만xhigh/max를 켜는 것이 비용 효율적입니다.
5. 추론 레벨·고속 모드 & API 호출 코드
세 모델 모두 이제 단순 텍스트 생성이 아니라 추론 강도(Thinking/Effort)와 응답 속도 티어(Fast/Ultrafast)를 API 파라미터로 직접 제어합니다. 바로 복사해 테스트할 수 있는 공식 형식 예제입니다.
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
-H "x-goog-api-key: $GEMINI_API_KEY" \
-H "Content-Type: application/json" \
-d '{
  "model": "gemini-4-neon",
  "input": "이 Next.js 라우터의 메모리 누수 원인을 찾고 수정 패치를 작성해줘.",
  "generation_config": {
    "thinking_level": "high"
  }
}'6. 마이그레이션 주의사항과 실전 상황별 매칭
기존 코드에서 모델 ID만 갈아 끼웠다가 400 Bad Request를 만나는 경우가 매우 많습니다. 특히 Claude Fable 5.2와 Gemini 4 Neon은 구형 추론 파라미터를 명시적으로 거부합니다. 아래 탐색기에서 상황별 최적 모델과 마이그레이션 해결책을 검색해 보세요.
- 매일 수십 번 PR 리뷰·단위 테스트·컴포넌트 작성을 돌리고 싶어요일상 주력· 코딩·에이전트
일상 코딩에 $8/$40 플래그십을 상시 쓰면 비용이 3~4배 불어납니다. Sol은 Codex v0.171 기본 모델로 자리 잡았고, 장문 맥락이 크면 Neon이 유리합니다.
권장 선택:GPT-6.2 Sol ($2/$10) 또는 Gemini 4 Neon ($3/$15)대안 / 참고:Claude Opus 5.5 ($4/$20) - 수십 개 파일이 얽힌 아키텍처 리팩토링·난해한 버그를 한 번에 끝내고 싶어요최고 정확도· 코딩·에이전트
SWE-bench Pro 93.0%, Multilingual 96.6%를 기록한 Fable 5.2가 복합 코드베이스 수정에서 가장 안정적입니다. 단, max 대신 xhigh로 시작해 토큰 폭증을 막으세요.
권장 선택:Claude Fable 5.2 (effort: xhigh)대안 / 참고:GPT-6.2 Astra - 300K~800K 토큰의 거대 코드베이스나 긴 데모 영상·PDF 스펙을 통째로 분석해야 해요초장문·멀티모달· 코딩·에이전트
Neon은 GraphWalks(256K~1M) 95.2%와 LVBench(긴 영상) 89.0%를 기록했고 1M 전 구간 추가 장문 할증이 없습니다.
권장 선택:Gemini 4 Neon (thinking_level: high)대안 / 참고:Claude Fable 5.2 (텍스트·이미지/PDF) - GPT-6.2 API 청구서가 예상보다 2배 가까이 높게 나왔어요비용 주의· 비용·속도 최적화
GPT-6.2 Astra와 Sol은 입력이 272K를 단 1토큰만 넘어도 요청 전체가 2배(출력 1.5배) 요율로 계산됩니다. 긴 컨텍스트는 주기적으로 요약하거나 할증이 없는 모델로 라우팅하세요.
권장 선택:입력 토큰이 272K를 넘지 않게 세션 압축대안 / 참고:장문 작업만 Gemini 4 Neon / Fable 5.2로 우회 - 실시간 음성·인터랙티브 코딩처럼 응답 속도가 체감상 너무 중요해요저지연· 비용·속도 최적화
Sol Ultrafast는 2027년 2월 말까지 $6/$30(3배)이며 ChatGPT Pro $200 요금제에도 포함됩니다. Fable 5.2 Fast는 출력 생성을 최대 2.5배 가속합니다(단 TTFT는 동일).
권장 선택:GPT-6.2 Sol Ultrafast 또는 Claude Fable 5.2 Fast대안 / 참고:Gemini 4 Hydrogen ($1.50/$7.50) - Claude Fable 5.2로 바꿨더니 400 오류가 쏟아져요필수 수정· API 마이그레이션 오류
Fable 5.2는 Adaptive Thinking을 끌 수 없으며 구형 budget_tokens, 샘플링 파라미터, assistant prefill, 강제 tool_choice를 모두 400 오류로 거절합니다. 또한 thinking 블록 재전송 시 이전 메시지나 시스템 프롬프트를 수정하면 Strict Prefix Check로 차단됩니다.
권장 선택:temperature·top_p·thinking.disabled·강제 tool_choice 제거대안 / 참고:output_config.effort와 tool_choice: auto 사용 - Gemini 4 Neon에서 thinking 설정을 넘겼는데 400 오류가 나요필수 수정· API 마이그레이션 오류
Neon은 구형 minimal 값을 지원하지 않으며 thinkingBudget과 thinkingLevel을 동시에 전달하면 400 오류를 반환합니다.
권장 선택:thinking_level을 low/medium/high/xhigh 중 하나로 변경대안 / 참고:deprecated된 thinkingBudget 필드 완전 삭제
7. 멀티 모델 라우팅 실전 4단계 전략
2026년 말 기준으로는 단일 모델 하나에 올인하기보다 역할별 2~3개 모델 조합을 쓰는 팀이 품질과 비용을 모두 잡습니다.
- 1기본 일상 모델 고정 (전체 작업의 70~80%)
gpt-6.2-sol / gemini-4-neon일반 기능 구현, 코드 리뷰, 문서 초안은 GPT-6.2 Sol($2/$10)이나 Gemini 4 Neon($3/$15, thinking_level: medium~high)에 배정해 월간 고정비를 억제합니다.
- 2고난도 에스컬레이션 모델 지정 (상위 15~20%)
claude-fable-5-2 / gpt-6.2-astra복합 멀티파일 리팩토링·아키텍처 설계는 Claude Fable 5.2(effort: high~xhigh), 보안 감사·과학 계산·고난도 법률/데이터 추론은 GPT-6.2 Astra로 넘깁니다.
- 3프롬프트 캐시 & 배치 API로 반복 비용 50~95% 절감
Batch API (0.5x) + Prompt Cache세 공급사 모두 Batch API 50% 할인을 제공하며, Gemini 4 Neon은 캐시 95% 할인($0.15), Claude Fable 5.2는 캐시 읽기 $0.20(0.025배)으로 시스템 프롬프트·저장소 컨텍스트 재사용 효과가 매우 큽니다.
- 4오케스트레이션 도구로 CLI 구독과 API 통합
Paseo / OpenCode / Claude Code / CodexCodex CLI, Claude Code, Google Antigravity, OpenCode 같은 에이전트 도구에서 작업 성격에 따라 모델을 전환하면 단일 벤더 종속 없이 최신 모델 이점을 바로 흡수할 수 있습니다.
8. 자주 묻는 질문 (FAQ)
Q1. Gemini 4 Carbon이 11월 말까지 $2/$10 프로모션인데 Neon($3/$15)을 쓸 이유가 있나요?
Q2. Claude Mythos 5.2와 Claude Fable 5.2는 무엇이 다른가요?
Q3. ChatGPT 일반 유료(Plus) 사용자도 GPT-6.2 Astra·Sol을 쓸 수 있나요?
Q4. Claude Fable 5.2에서 안전 필터로 요청이 차단되면 어떻게 처리되나요?
Q5. 기존 코딩 에이전트(OpenCode, Claude Code, Codex)에서 바로 쓸 수 있나요?
Hafuture 실시간 환율 계산기로 월간 AI API 비용 원화 환산하기
Gemini 4 Neon($3/$15), GPT-6.2 Sol($2/$10), Claude Fable 5.2($8/$40)의 달러 기준 API 예상 청구액을 실시간 환율로 바로 계산해 보세요.